
মূল বক্তব্য
আজকালকার অ্যাপ্লিকেশনগুলো ডেটা-নির্ভর – মানে সমস্যা হয় সাধারণত কম্পিউটিং পাওয়ারের কারণে নয়, বরং ডেটার জটিলতা, পরিমাণ বা গতির কারণে। অধিকাংশ সিস্টেম তৈরি করা হয় স্ট্যান্ডার্ড ব্লকগুলো ব্যবহার করে—যেমন: ডেটাবেস, ক্যাশ, মেসেজ কিউ। একজন আর্কিটেক্টের কাজ হলো এই ব্লকগুলোকে এমনভাবে মিলিয়ে দেওয়া যাতে সিস্টেম তিনটি মূল দিক পূরণ করে: Reliability (বিশ্বস্ততা), Scalability (স্কেলেবল), Maintainability (রক্ষণাবেক্ষণযোগ্যতা)।
Reliability
কোন সমস্যা হলেও যেন , সিস্টেম ঠিকঠাক কাজ করা চালিয়ে যেতে পারে - ইউজার যেন ব্যাবহার করতে পারে ।
ভুল (Fault) vs ব্যর্থতা (Failure):
ভুল হলো কোনো যন্ত্রাংশের সমস্যা (যেমন হার্ডডিস্ক নষ্ট)।
ব্যর্থতা হলো পুরো সিস্টেম ব্যবহারকারীর জন্য কাজ করা বন্ধ করে দেওয়া।
লক্ষ্য: ভুল একেবারে আটকানো যায় না, কিন্তু সিস্টেমকে এমনভাবে ডিজাইন করতে হবে যেন ভুল ব্যর্থতা-তে পরিণত না হয়। একে বলে ফল্ট-টলারেন্ট সিস্টেম।ভুলের ধরন:
হার্ডওয়্যার ভুল: যন্ত্রাংশ নষ্ট হওয়া। সমাধান: অতিরিক্ত ব্যাকআপ রাখা (যেমন একাধিক হার্ডডিস্ক, RAID, dual power supply)।
সফটওয়্যার ভুল: সিস্টেমে বাগ থাকা- যা সবসময় এড়ানো যায় না। এটি অপ্রত্যাশিত এবং মাঝে মাঝে বড় সমস্যা তৈরি করে।
মানুষের ভুল: কনফিগারেশন বা অপারেশন ভুল → সিস্টেম ডিজাইন এমন হওয়া উচিত যাতে মানুষ ভুল করার সুযোগ কম হয় (sandbox, clean abstraction)।
Scalability
লোড (চাপ) বাড়লেও সিস্টেম যেন সেটা সামলানোর ক্ষমতা রাখে
লোড চেনা: প্রতিটি অ্যাপের জন্য লোড প্যারামিটার আলাদা। যেমন:
requests per second
read/write ratio
আমরা একটু পরে , দেখবো Twitter ( বর্তমানে X ) তাদের লোড কিভাবে সামাল দিয়েছে ।
পারফরম্যান্স বোঝা: লোড বাড়লে সিস্টেমের আচরণ কেমন হয়?
লেটেন্সি vs রেসপন্স টাইম: লেটেন্সি হলো রিকোয়েস্ট প্রসেস হওয়ার সময়। রেসপন্স টাইম হলো একটি রিকুয়েস্ট করার পর , রেসপন্স পাওয়া পর্যন্ত ক্লাইন্ট কতক্ষণ অপেক্ষা করল।
শতকরা (Percentiles): শুধু অ্যাভারেজ দেখানো ঠিক নয়, কারণ কয়েকটা ধীর রিকোয়েস্ট গড় নষ্ট করে দেয়। তাই p95, p99 (৯৫তম, ৯৯তম পার্সেন্টাইল) দেখা উচিত – যাতে slower রিকোয়েস্টগুলোর খবর থাকে।
Tail Latency-এর গুরুত্ব:
উচ্চ percentile মনিটর করা গুরুত্বপূর্ণ কারণ slow outliers প্রায়ই সবচেয়ে মূল্যবান user-দের প্রভাবিত করে।বেশি data থাকা user (যেমন দীর্ঘ purchase history) সাধারণত slow requests generate করে।
tail user-এর performance ঠিক রাখা জরুরি, কারণ তারা বেশি revenue generate করে।
লোড সামলানো:
Vertical Scaling (Up): শক্তিশালী মেশিন ব্যবহার। র্যাম ২জিবি থেকে ৪জিবিতে বাড়ানো ।
Horizontal Scaling (Out): অনেক ছোট মেশিনে লোড ভাগ করা (shared-nothing architecture)। ২জিবি র্যাম একটা ২টা মেশিন নেয়া ।
Elasticity: লোড বেড়ে গেলে স্বয়ংক্রিয়ভাবে রিসোর্স যোগ করা।
Maintainability
ইঞ্জিনিয়ার ও অপারেশনস টিমের জীবন সহজ করে দেওয়া। সফটওয়্যারের বেশিরভাগ খরচ প্রথমে বানানোর সময় নয়, পরে রক্ষণাবেক্ষণে হয়।
Minimize pain during maintenance. তাই সিস্টেম তিনটি নীতি মেনে চলবে:
Operability: "Make it easy for operations teams to keep the system running smoothly." মনিটরিং, অটোমেশন ইত্যাদি দিয়ে অপারেশন টিমের কাজ সহজ করা।
Simplicity: "Make it easy for new engineers to understand the system" , নতুন ইঞ্জিনিয়ার যেন সহজেই সিস্টেম বুঝতে পারে। এটা করা যায় অ্যাবস্ট্রাকশন দিয়ে – জটিল অংশগুলোকে লুকিয়ে একটি পরিষ্কার ইন্টারফেস দেওয়া।
Evolvability: "Make it easy for engineers to make changes to the system in the future.” ভবিষ্যত প্রয়োজনে সিস্টেমকে সহজে পরিবর্তন / আপগ্রেড করা যাবে।
Latency VS Response Time VS Throughput
Latency মানে কী?
Latency হলো — Request পাঠানোর পর প্রথম response আসতে যত সময় লাগে।
📦 Restaurant উদাহরণ আমি waiter-কে বললাম, “একটা pizza চাই।”
Waiter কথা শুনে kitchen-এ গেল
Order kitchen-এ পৌঁছাতে যত সময় লাগলো
এই সময়টাই Latency
মানে, কাজটা শুরু হতে দেরি কত।
Response Time মানে কী?
Response Time হলো — Request পাঠানো থেকে শুরু করে পুরো কাজ শেষ হয়ে final response পাওয়া পর্যন্ত সময়।
📦 একই Restaurant উদাহরণ
Order দেওয়া
Pizza বানানো
Pizza টেবিলে আসা
সব মিলিয়ে যত সময়
এটাই Response Time
মানে, কাজটা পুরো শেষ হতে কত সময় লাগলো।
Website উদাহরণ
একটা link-এ click করলাম
200ms পরে server reply শুরু করলো Latency = 200ms
Page পুরো load হতে 2s লাগলো Response Time = 2s
Throughput মানে কী?
Throughput হলো — নির্দিষ্ট সময়ের মধ্যে কতগুলো request / কাজ complete করা যায়। মানে, system একসাথে কতটা কাজ সামলাতে পারে। সাধারণত কয়েকটা প্যারামিটার দিয়ে মাপা যায়:
Requests per second (RPS)
Transactions per second
Users per minute
Restaurant উদাহরণে Throughput
একটা restaurant:
- ১ ঘণ্টায় ৩০টা pizza বানিয়ে serve করতে পারে , Throughput = 30 pizza/hour
আরেকটা restaurant:
Pizza বানাতে সময় বেশি নেয়
কিন্তু একসাথে অনেকগুলো pizza বানাতে পারে
তাহলে:
Latency বেশি হতে পারে
কিন্তু Throughput বেশি হতে পারে
Website উদাহরণে Throughput
একটা website:
- ১ সেকেন্ডে ১০০টা request handle করতে পারে, Throughput = 100 requests/second
অথবা,
- ১ মিনিটে ৬,০০০ user serve করতে পারে, Throughput = 6000 users/min

🔁 এক নজরে তুলনা
| Term | কী বোঝায় |
| Latency | Request পাঠানোর পর প্রথম response আসতে দেরি |
| Response Time | Request → পুরো কাজ শেষ → final response |
| Throughput | একক সময়ে কতগুলো কাজ complete হয় |
Abstractions এবং সিস্টেমের জটিলতা কমানো
মূল ধারণা:
Abstraction হলো সিস্টেমের জটিলতা (complexity) ম্যানেজ করার প্রধান হাতিয়ার। এটি accidental complexity দূর করতে সাহায্য করে—অর্থাৎ যেটা বাস্তব সমস্যা থেকে নয়, বরং implementation থেকে আসে।
Implementation-এর জটিলতা লুকিয়ে একটি পরিষ্কার এবং সহজ বোঝার interface দেওয়ায়, abstraction সিস্টেমকে সহজে বোঝা, maintain করা এবং evolve করা সম্ভব করে।
Abstraction কীভাবে simplicity আনে:
Implementation Details লুকানো:
ভালো abstraction জটিল অভ্যন্তরীণ যন্ত্রাংশকে “façade” (বিল্ডিং-এর সামনের সুন্দর অংশ ভিতরে কীভাবে wiring, pipe, concrete আছে — আমরা দেখি না) -এর আড়ালে লুকায়। ডেভেলপারদের inner workings বোঝার দরকার হয় না।উদাহরণ: High-level programming languages → CPU registers, machine code, system calls লুকিয়ে দেয়।
উদাহরণ: SQL → ডেটার on-disk structure বা concurrent request handling নিয়ে ভাবতে হয় না।
উদাহরণ: Standard data systems (databases, caches) → প্রতিটি অ্যাপ্লিকেশনের জন্য নতুন storage engine লিখতে হয় না।
Reuse এবং Quality:
Abstraction একই componentকে বিভিন্ন অ্যাপ্লিকেশনে reuse করা সম্ভব করে।- ফলে underlying improvements (performance optimization, bug fixes) সব application-এ benefit দেয়।
Layering এবং Specialization:
অনেক সিস্টেম layered structure-এ তৈরি হয়, যেখানে প্রতিটি layer নিচের layer-এর complexity abstract করে।Database engineer → byte-level storage বা network handling নিয়ে কাজ করে।
Application developer → real-world data বা object manipulation-এ focus করতে পারে, storage mechanics database layer-এ ছেড়ে।
Distributed Systems-এর চ্যালেঞ্জ:
Abstractions খুবই গুরুত্বপূর্ণ, কিন্তু ভালো abstraction খুঁজে পাওয়া distributed systems-এ কঠিন।
অনেক কার্যকর algorithm থাকলেও, সেগুলোকে এমনভাবে package করা যা complexity manage করতে পারে, বড় চ্যালেঞ্জ।
Designing Data-Intensive Applications-এর বড় লক্ষ্য: ভালো abstractions চিহ্নিত করা, যাতে বড় সিস্টেমের অংশগুলো well-defined এবং reusable component হিসেবে extract করা যায়।
🐦 টুইটারের উদাহরণ (Twitter Case Study - 2012)
টুইটারের প্রধান দুটি অপারেশন হলো:
Post Tweet: নতুন টুইট পাবলিশ করা (গড়ে 4.6k/sec, পিকে 12k/sec)।
Home Timeline: ফলো করা মানুষদের টুইট দেখা (300k/sec)।
টুইটারের মূল চ্যালেঞ্জ টুইট ভলিউম নয়, বরং Fan-out (একজন টুইট করলে তা সবার কাছে পৌঁছে দেওয়া)। এটি সমাধানের দুটি উপায় আছে:
🏗️ Approach 1: Read-time Aggregation (Pull Model)
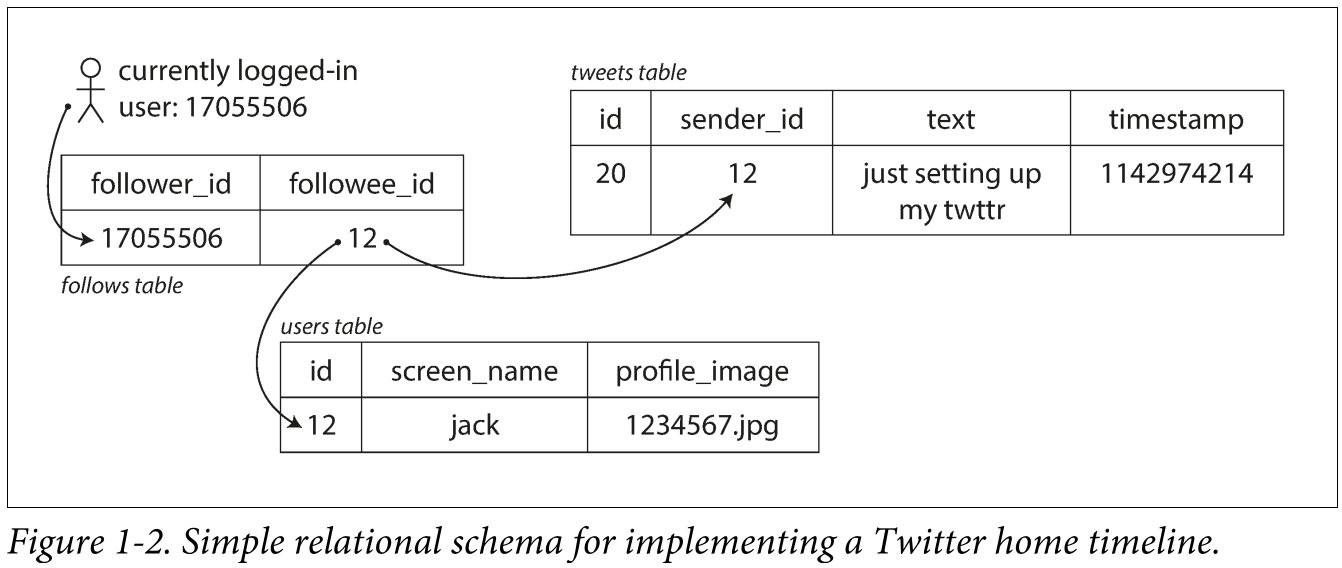
এই পদ্ধতিতে নতুন টুইট সরাসরি একটি গ্লোবাল ডেটাবেস টেবিলে জমা হয়। যখন কোনো ব্যবহারকারী তার টাইমলাইন দেখতে চায়, তখন সিস্টেম একটি কুয়েরি চালিয়ে ডেটা খুঁজে আনে।
SQL Query:
SQL
SELECT tweets.*, users.* FROM tweets
JOIN users ON tweets.sender_id = users.id
JOIN follows ON follows.followee_id = users.id
WHERE follows.follower_id = current_user
সুবিধা: টুইট করা বা রাইট অপারেশন খুব দ্রুত হয়।
অসুবিধা: টাইমলাইন লোড করার সময় (Read) সিস্টেমের ওপর অনেক চাপ পড়ে এবং পারফরম্যান্স কমে যায়।
⚡ Approach 2: Write-time Fan-out (Push Model)
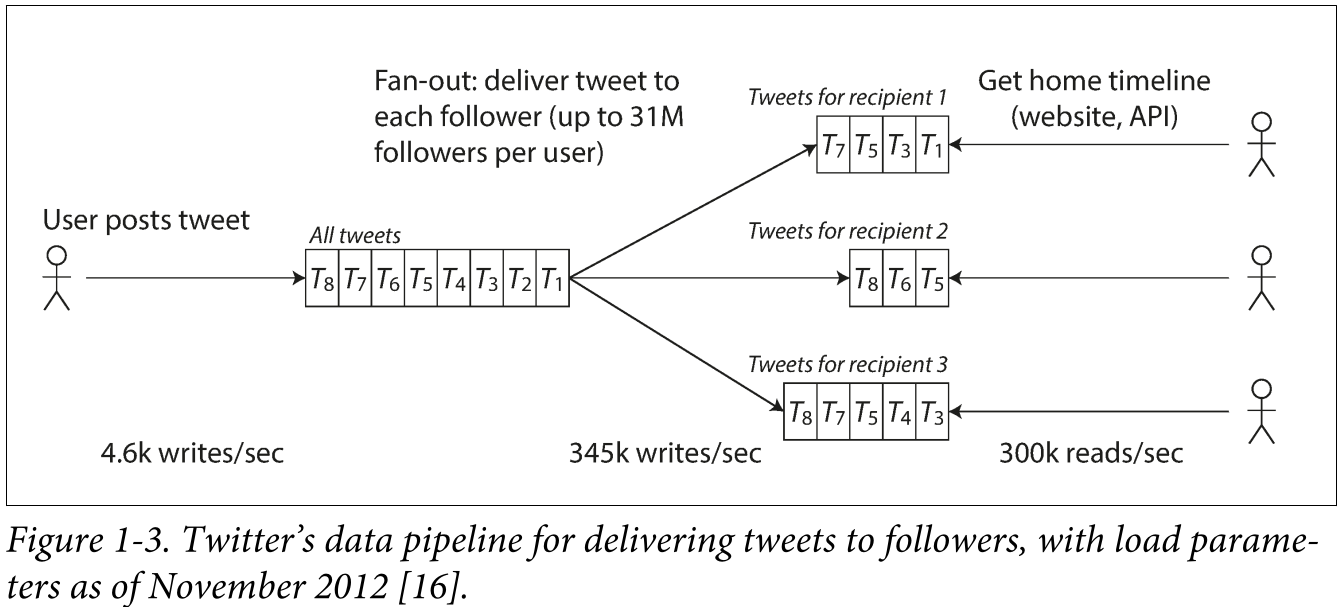
এখানে প্রতিটি ব্যবহারকারীর জন্য একটি আলাদা Home Timeline Cache (মেইলবক্সের মতো) থাকে। যখন কেউ টুইট করে, সিস্টেম তার সব ফলোয়ারের ক্যাশে সেই টুইটটি সাথে সাথে পুশ করে দেয়।
সুবিধা: টাইমলাইন রিড করা খুব সহজ ও দ্রুত হয়, কারণ এটি আগে থেকেই তৈরি থাকে।
অসুবিধা: রাইট করার সময় অনেক কাজ করতে হয়। গড়ে একজন ইউজারের ৭৫ জন ফলোয়ার থাকলেও, সেলিব্রিটিদের ক্ষেত্রে (যেমন ৩০ মিলিয়ন ফলোয়ার) একটি টুইট করলে ৩০ মিলিয়ন রাইট অপারেশন করতে হয়।
⚖️ The Final Twist: Hybrid Approach
টুইটার বর্তমানে এই দুটি পদ্ধতির একটি মিক্সড ভার্শন বা হাইব্রিড মডেল ব্যবহার করে:
সাধারণ ব্যবহারকারী: এদের জন্য Approach 2 ব্যবহার করা হয়। টুইট করার সাথে সাথে ফলোয়ারদের ক্যাশ আপডেট হয়।
সেলিব্রিটি (High Fan-out): যাদের অনেক বেশি ফলোয়ার, তাদের টুইটগুলো সবার ক্যাশে পাঠানো হয় না। পরিবর্তে, যখন কোনো ফলোয়ার টাইমলাইন ওপেন করে, তখন ওই সেলিব্রিটির টুইটগুলো Approach 1 অনুযায়ী টেনে এনে সাধারণ টুইটগুলোর সাথে মার্জ (Merge) করা হয়।
ফলাফল: এই হাইব্রিড পদ্ধতিতে টুইটার সব ধরনের ইউজারের জন্যই দ্রুত এবং স্থিতিশীল পারফরম্যান্স নিশ্চিত করতে পারে।
সংক্ষেপে
Reliability, Scalability, Maintainability একসাথে থাকা চ্যালেঞ্জিং। কোনো এক “ম্যাজিক সলিউশন” নেই। এই নোটটি ভবিষ্যতের অধ্যায়ে সিস্টেম ডিজাইন, অ্যালগরিদম ও ট্রেড-অফগুলো বুঝতে সাহায্য করবে।

